长对话压缩器(精简上下文|持续提效|节省token)
@user_af163eaa/z-context-compressor
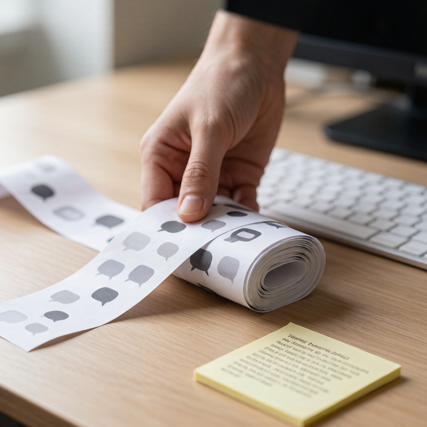
把冗长对话折成精炼摘要,省 token 还不丢关键信息。 长对话跑久了,上下文越积越重,既拖慢响应又烧 token,还可能让模型"忘了"前面的重点。长对话压缩器会在你察觉变慢时,把整段历史折叠成结构化摘要——保留关键决策、待办、约束和结论,剥离寒暄与冗余来回。下次对话带着这份摘要继续,模型既能接上上下文,又不必重读几万字的原始记录。它支持手动触发或阈值自动提醒,压缩前后给你对比报告,确保没丢重要信息。特别适合跨几天、多轮次的复杂任务,让长线协作始终轻装上阵,不卡顿、不超窗口。
v1.0.0

将提示词发送给你的 AI 安装该 skills
请根据 https://skillhub.cn/install/skillhub.md,安装 @user_af163eaa/z-context-compressor。
将提示词发送给你的 AI 安装该 skills
请根据 https://skillhub.cn/install/skillhub.md,安装 @user_af163eaa/z-context-compressor。
 下载 Zip 包安装


相关推荐